简历筛选,从头到尾
Lumenvale Software 的招聘人员手头有一份职位描述和十份简历需要公平比较,却没有简单的办法, 把一份候选人名单的评判依据拿回原始记录去核对。iMBrace 把职位描述转化为一组经过认可的筛选 标准,用每份简历自己的原文作为证据,对照这些标准为每份简历打分,并给出一份经过排序、招聘 人员可以质疑也可以信赖的候选人名单。
具体流程,一步步来看
完整的过程是这样的:
- 招聘人员从一份职位描述和十份简历开始——这次要招聘的是一位客户成功经理。
- “文档模块”(DocIQ),也就是 iMBrace 的文档阅读器,读取这份职位描述,提取出其中的要求。
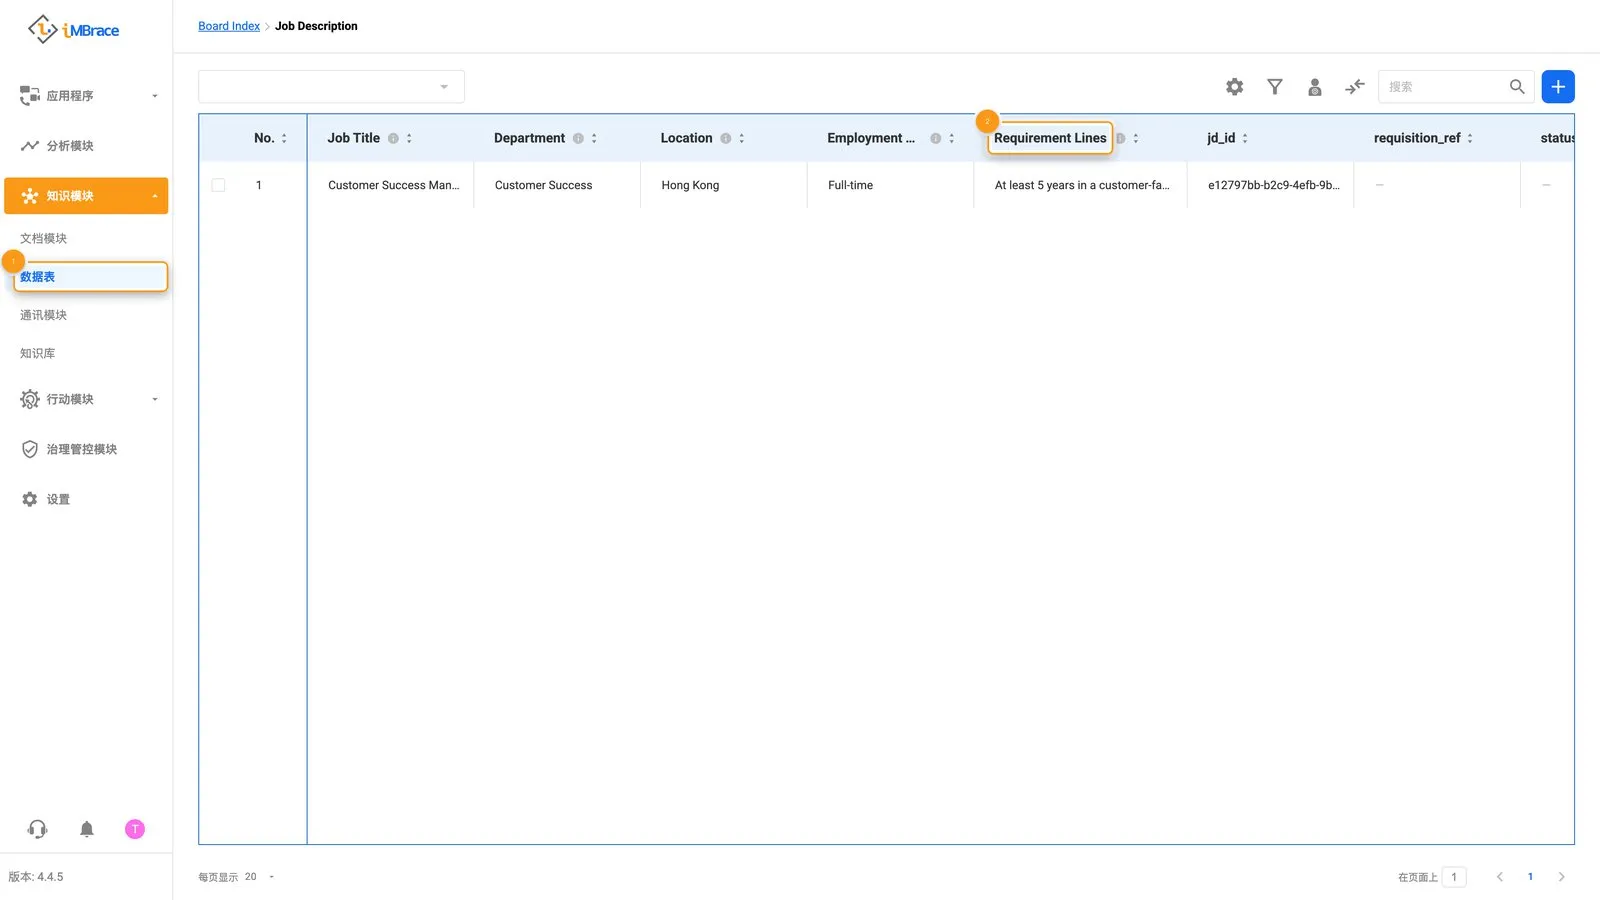 1 “知识模块”(Knowledge)>“数据表”(DataIQ)。2 职位描述中的各项要求,被读取为“Requirement Lines”字段。
- 一个名为 Criteria Architect 的智能体,根据这些要求提出一组筛选标准,并标明每一条标准 的出处。
- 招聘人员在一张表上查看这些标准——这是“数据表”(DataIQ)中的一张结构化表——勾选要 采用的标准,然后点击“保存”(Save)。
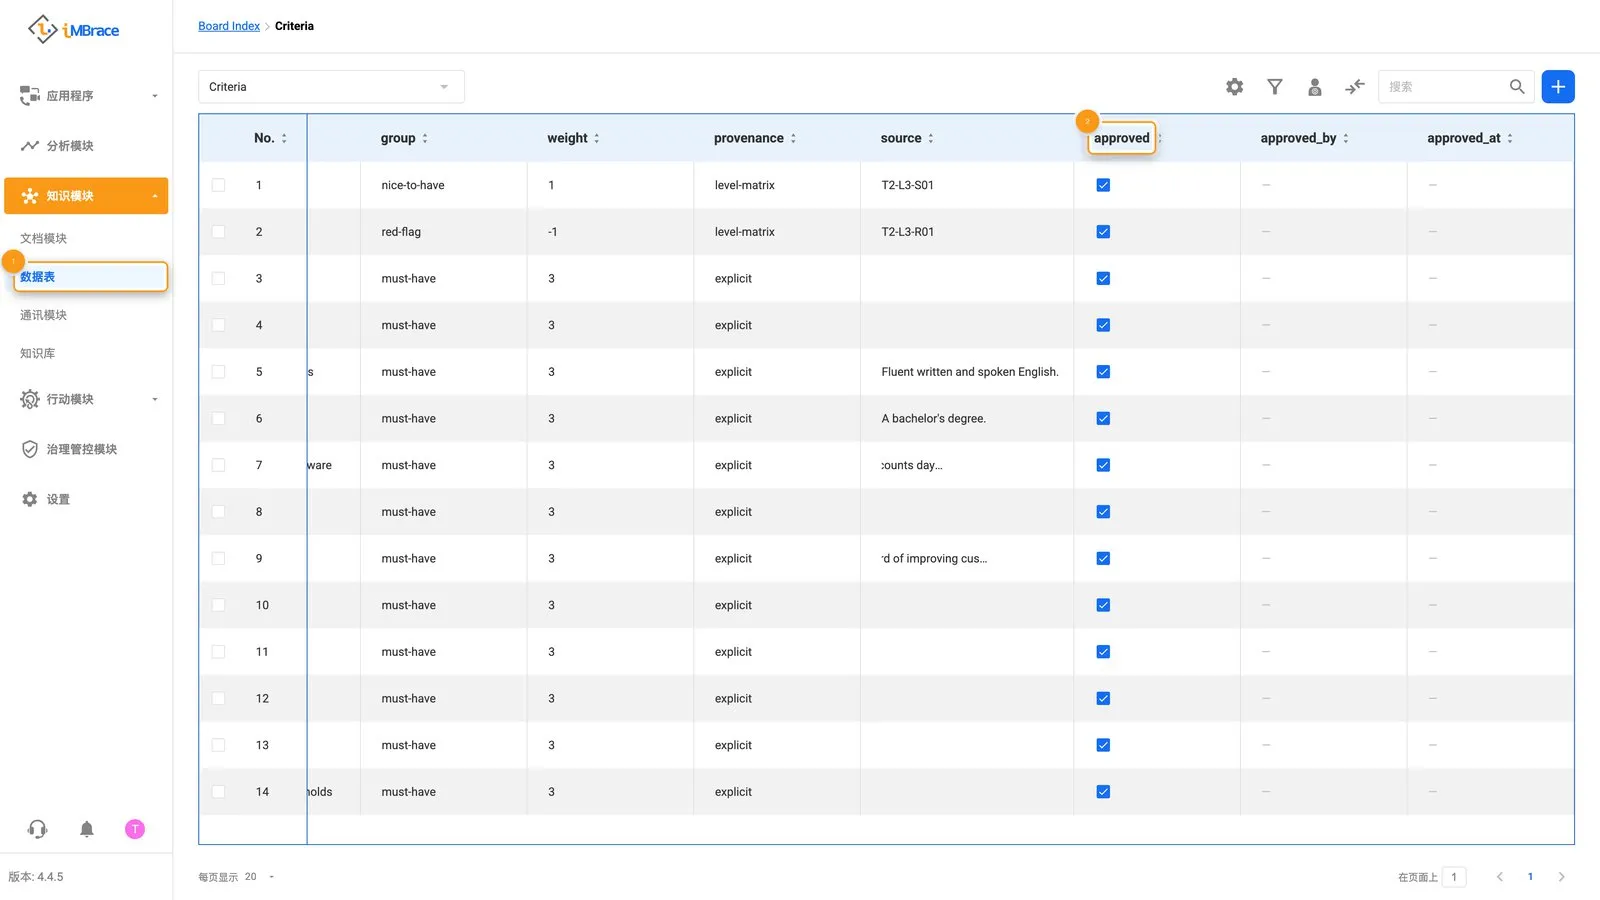 1 “知识模块”(Knowledge)>“数据表”(DataIQ)。2 每一项标准都已批准,在“approved”字段打勾。
- 接下来录入十份简历。每份简历都成为一条独立记录,候选人的工作经历和教育背景会被完整读 取出来。
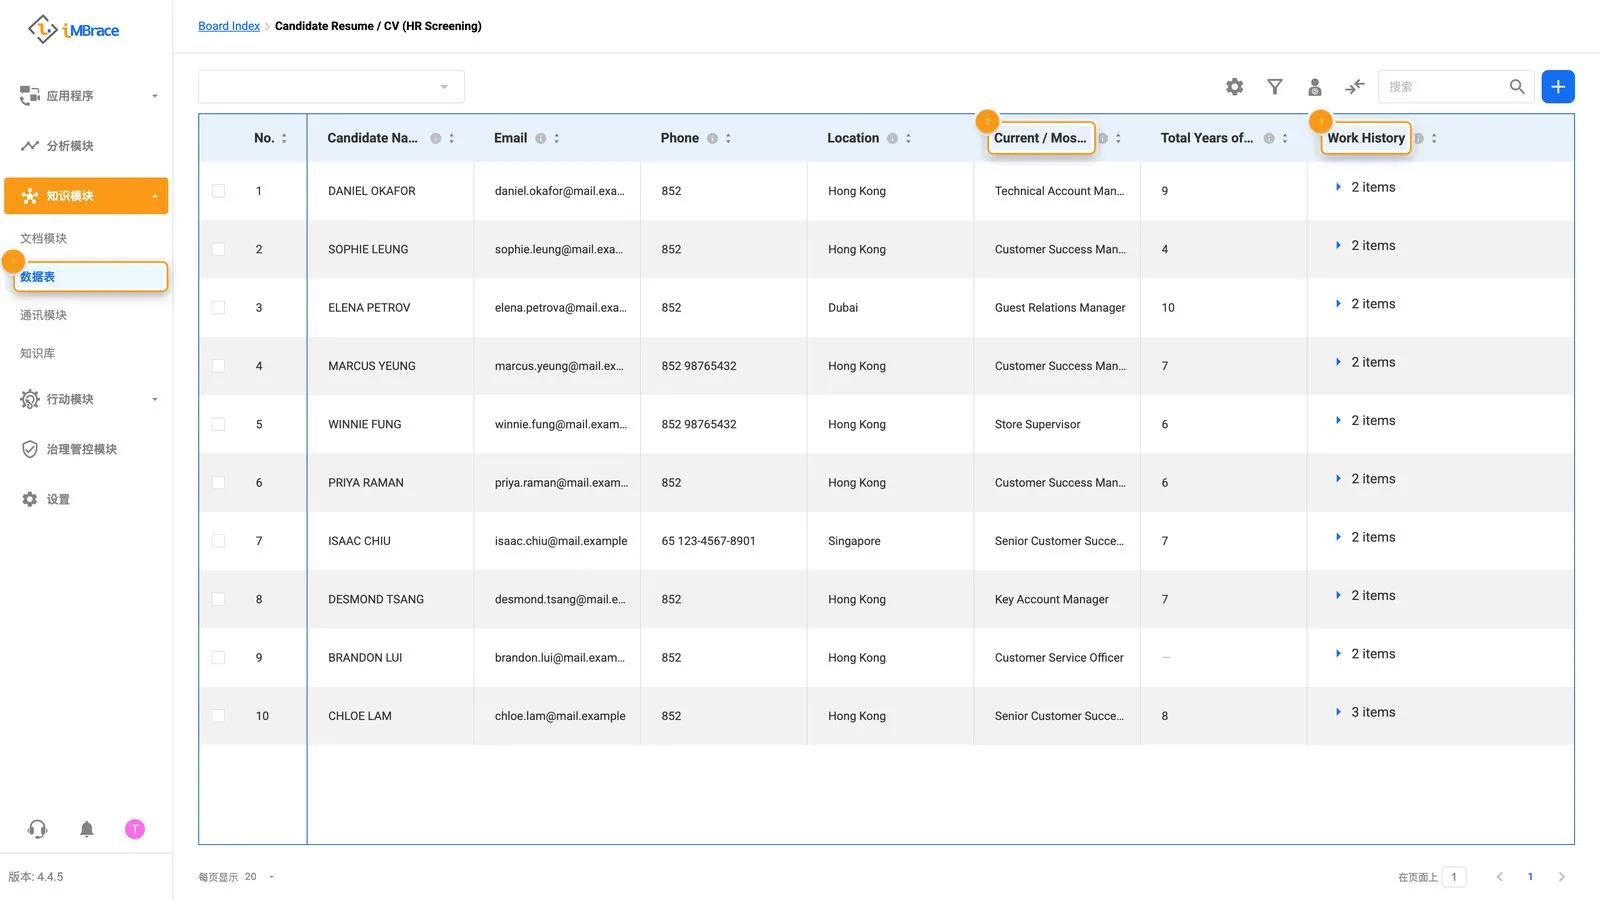 1 “知识模块”(Knowledge)>“数据表”(DataIQ)。2 一位应聘者的记录,包括“Current / Most Recent Title”等字段。3 同一条记录的“Work History”字段。
- 第二个智能体 Evidence Assessor,依照已获批准的标准为每份简历打分,并引用简历中支持 每个分数的那句原文。
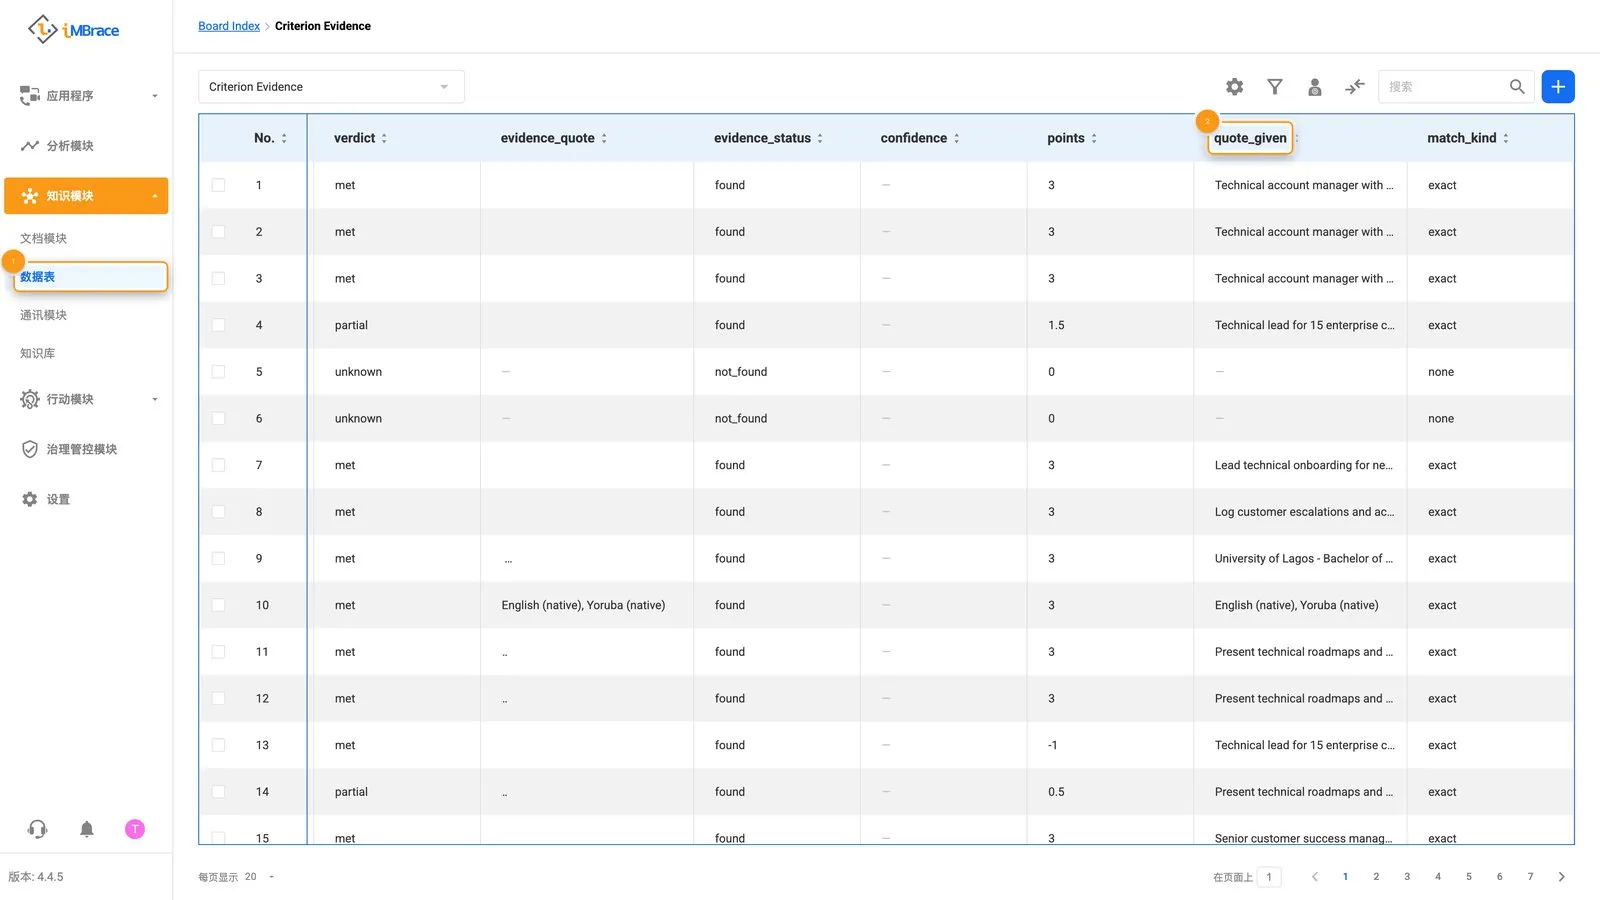 1 “知识模块”(Knowledge)>“数据表”(DataIQ)。2 一项评分背后、引自简历的原文,在“quote_given”字段。
- 这些分数汇总到 Candidate Scorecard 上,按匹配程度从强到弱排序。
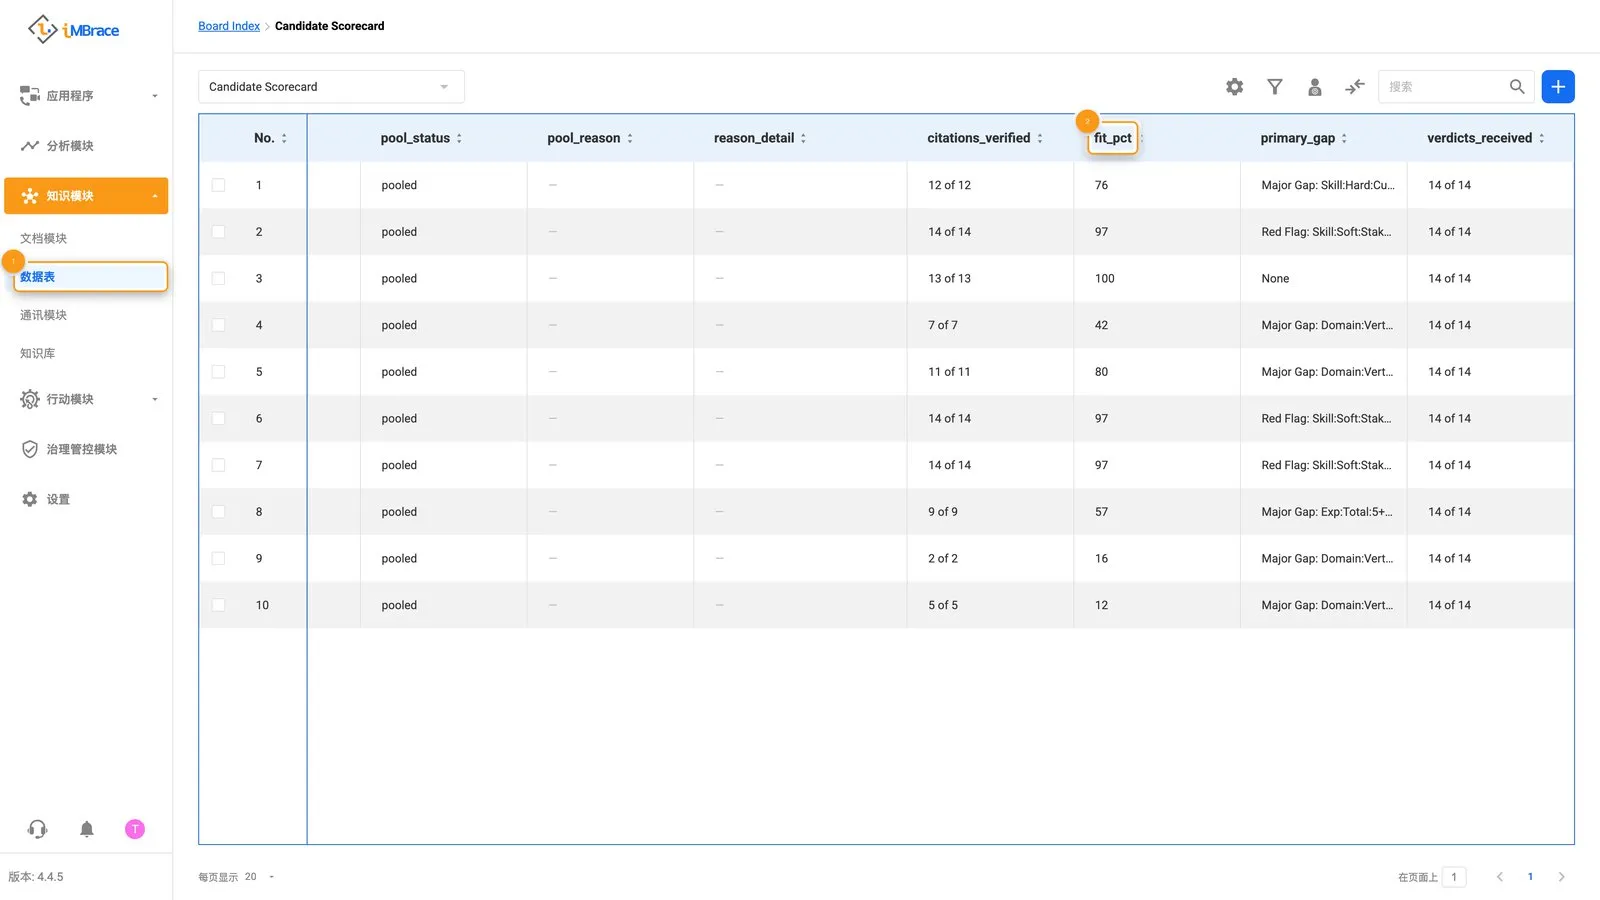 1 “知识模块”(Knowledge)>“数据表”(DataIQ)。2 每位候选人的匹配百分比,在“fit_pct”字段。
- 招聘人员在“分析模块”(InsightsIQ)——iMBrace 会附上依据来源作答的对话工具——里,向 第三个智能体 Screening Analyst 询问候选人名单,以及某位候选人为何排在这个位置。答案 会附带背后引用的简历原文。
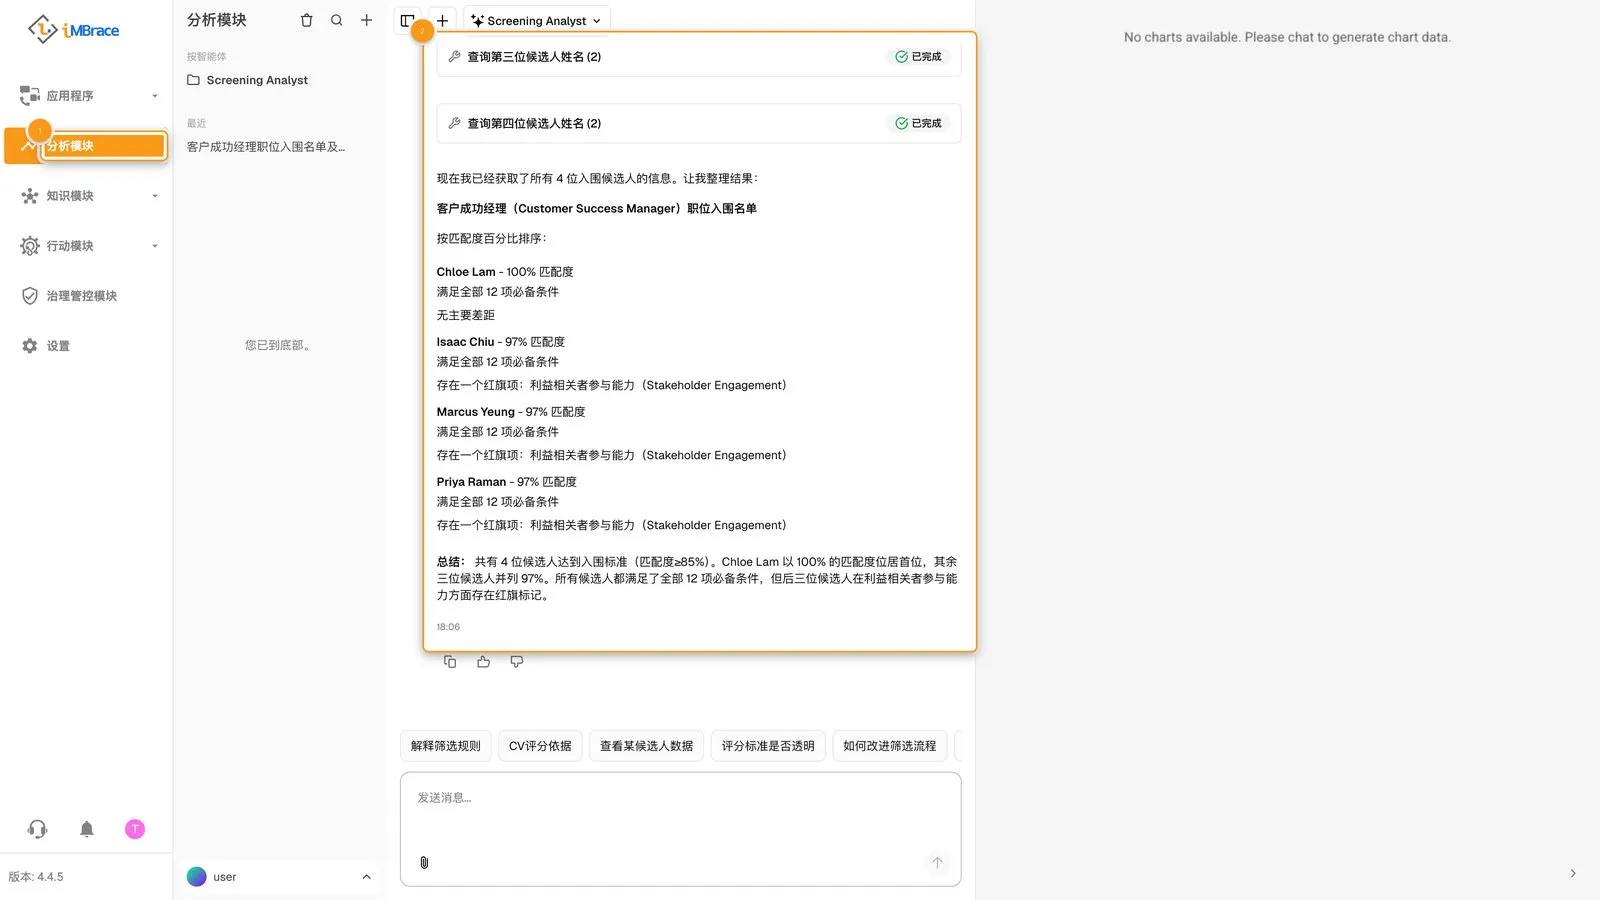 1 侧边栏的“分析模块”(InsightsIQ)。2 Screening Analyst 的入围名单回复。
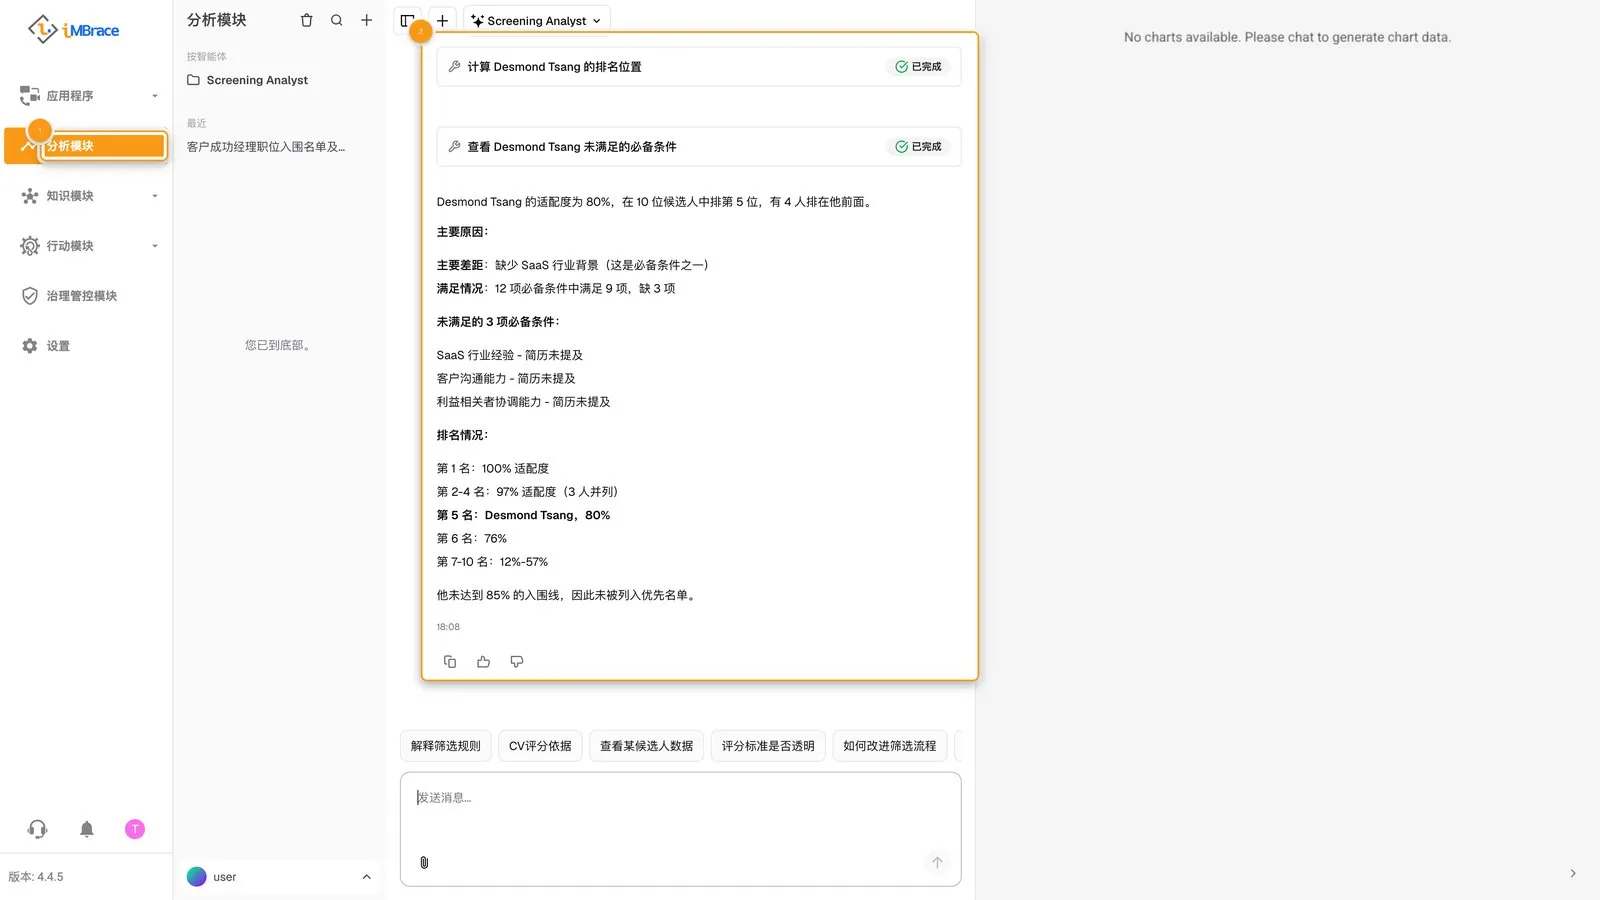 1 侧边栏的“分析模块”(InsightsIQ)。2 Screening Analyst 说明某候选人排名原因的回复。
由人来决定的地方
在任何一份简历被打分之前,招聘人员先批准这些标准:在 Criteria 数据表上逐条勾选,然后点击 保存。这一步安排在打分开始之前,确保每份简历都是按照招聘人员真正认可的标准来衡量,而不是 智能体自行假设的标准。
不写代码也能调整的内容
简历打分依据的标准,以及候选人需要达到的水平,都是数据表上的行。
| 行 | 控制的内容 |
|---|---|
| Criteria 数据表上的每一条标准 | 简历会被拿来对照的内容——必备、加分或警示项——以及招聘人员是否已批准这一条。 |
| Level Expectations 数据表上的每一行 | 在某个方向上达到某个水平意味着什么,这样一条标准就可以指向某个水平,而不是一条固定规则。 |
新增、编辑或停用一行,下一份被打分的简历就会读取到这一变化——不需要重新搭建。
试一试
如果你是合作伙伴,你的练习组织会自带已经安装好的简历筛选功能,使用 Lumenvale Software 的 职位描述和简历,你的合作伙伴资料包中的演示脚本,会带你实际跑一遍整个流程,从标准批准一直 到候选人名单。其他人都可以请自己的 iMBrace 联系人,在一个属于自己的组织上看这个流程演示。